This blog post is also available in 🇬🇧 English: Symfony on Clever Cloud #7: observability, what the platform provides and what we add.
Transparence. Je suis ambassadeur Clever Cloud. J’écris cette série en toute indépendance, personne chez eux ne relit cette série, et je m’y autorise les mêmes critiques que sur n’importe quelle autre plateforme.
Depuis le précédent article, l’application de démonstration tourne sur plusieurs instances, avec ses workers et son Schedule. On sait la déployer, mais une fois en production, impossible de dire quelles requêtes sont lentes ou pourquoi un message échoue.
Voyons ce que Clever Cloud fournit sans rien configurer, puis ce qu’il faut ajouter à l’application : des métriques Prometheus, que la plateforme sait collecter elle-même, et des traces OpenTelemetry, envoyées vers un OpenObserve hébergé lui aussi sur Clever Cloud.
Un raccourcisseur de liens à observer
Jusqu’ici, l’application n’avait aucune fonctionnalité visible, et donc pas grand-chose à observer. Ajoutons-lui un raccourcisseur de liens : on colle une URL sur la page d’accueil, l’application la remplace par un code de six caractères, et /{code} redirige vers la page d’origine en comptant les clics.
#[Route('/', name: 'link_index', methods: ['GET', 'POST'])]
public function index(Request $request, LinkRepository $links, EntityManagerInterface $entityManager, MessageBusInterface $bus): Response
{
    $form = $this->createForm(ShortenLinkType::class);
    $form->handleRequest($request);

    if ($form->isSubmitted() && $form->isValid()) {
        $link = new Link(ByteString::fromRandom(6)->toString(), $form->get('url')->getData());
        $entityManager->persist($link);
        $entityManager->flush();

        $bus->dispatch(new FetchLinkTitle($link->getId()));

        return $this->redirectToRoute('link_index');
    }

    return $this->render('link/index.html.twig', [
        'form' => $form,
        'links' => $links->findLatest(),
    ]);
}

#[Route('/{code}', name: 'link_redirect', requirements: ['code' => '[a-zA-Z0-9]{6}'], methods: ['GET'])]
public function redirectToTarget(#[MapEntity(mapping: ['code' => 'code'])] Link $link, LinkRepository $links): RedirectResponse
{
    $links->countClick($link);

    return $this->redirect($link->getUrl());
}
Pour afficher un titre plutôt qu’une URL brute dans la liste des liens, l’application va chercher la page cible. Ce site peut être lent, voire injoignable, alors ce travail part dans la file async et c’est le worker Messenger déjà en place qui s’en charge :
#[AsMessageHandler]
final readonly class FetchLinkTitleHandler
{
    // Constructeur : LinkRepository, EntityManagerInterface, HttpClientInterface, LoggerInterface

    public function __invoke(FetchLinkTitle $message): void
    {
        $link = $this->links->find($message->linkId);

        if (null === $link) {
            return;
        }

        $context = [
            'code' => $link->getCode(),
            'host' => parse_url($link->getUrl(), \PHP_URL_HOST),
        ];

        try {
            $html = $this->httpClient->request('GET', $link->getUrl(), ['timeout' => 5])->getContent();
        } catch (\Throwable $e) {
            $this->logger->warning('Impossible de récupérer la page cible.', $context + ['error' => $e->getMessage()]);

            throw $e;
        }

        $title = \Dom\HTMLDocument::createFromString($html, \LIBXML_NOERROR)->title;
        $link->setTitle('' !== $title ? mb_substr($title, 0, 255) : null);
        $this->entityManager->flush();

        $this->logger->info('Titre récupéré.', $context + ['title' => $link->getTitle()]);
    }
}\Dom\HTMLDocument, arrivé avec PHP 8.4, lit le titre sans dépendance supplémentaire. Si le site cible ne répond pas, l’exception remonte, Messenger rejoue le message trois fois, si besoin, puis le range dans le transport failed. Ce comportement vient de la configuration par défaut de Messenger, il suffit d’ajouter la ligne qui route FetchLinkTitle vers async.
Avec ça, une seule action de l’utilisateur fait travailler le contrôleur, la base, la file de messages, le worker et un site extérieur : il y a enfin de quoi observer 😅
Les outils à installer dans l’application
Avant d’installer quoi que ce soit, posons le vocabulaire.
Une métrique est un nombre que l’on mesure à intervalles réguliers : l’utilisation du CPU, le nombre de liens créés, la durée moyenne des requêtes. Mises bout à bout, ces mesures donnent une courbe, qui montre une tendance dans le temps.
Une trace raconte le parcours d’une seule requête, ou d’un seul message, à travers l’application. Elle se découpe en spans, et chaque span est une étape de ce parcours (la requête HTTP, une requête SQL, l’appel à un site extérieur), avec son début, sa durée et son éventuelle erreur. Les spans s’emboîtent : la requête SQL est l’enfant de la requête HTTP qui l’a déclenchée.
Côté code, il faut deux briques. Pour les métriques, le bundle artprima/prometheus-metrics-bundle expose une route au format Prometheus. Pour les traces, le bundle traceway/opentelemetry-symfony instrumente Symfony en PHP pur : requêtes HTTP, Messenger, HttpClient, Doctrine, Twig… Il s’appuie sur le SDK d’OpenTelemetry pour PHP, auquel il faut ajouter l’exporteur OTLP.
composer require artprima/prometheus-metrics-bundle
composer require traceway/opentelemetry-symfony open-telemetry/exporter-otlp
Les recettes Flex de ces deux bundles viennent du dépôt « contrib » : Composer demande s’il doit les appliquer, répondez oui. Elles ajoutent notamment la route /metrics/prometheus et un fichier config/packages/open_telemetry.yaml.
Note : OpenTelemetry propose aussi une instrumentation officielle. Elle repose sur une extension PHP écrite en C, et son instrumentation de Doctrine trace aussi l’interrogation de la file par le worker, plusieurs requêtes par seconde, de quoi noyer tout le reste. Le bundle de Traceway, un éditeur d’APM, fonctionne avec n’importe quel outil compatible OpenTelemetry, n’a besoin d’aucune extension, et ne trace une requête SQL que si elle fait partie d’une requête HTTP ou du traitement d’un message.
Les logs
Commençons par ce qui ne demande rien. Tout ce que l’application écrit sur sa sortie standard ou sa sortie d’erreur arrive dans les logs de Clever Cloud, ceux du serveur web comme ceux des workers. On les lit dans la console, ou avec la CLI :
clever logs -a symfony-clever-demo --since 1h --search "Impossible de récupérer"Créons un lien vers un site qui n’existe pas. À chaque tentative, le worker écrit :
WARNING [app] Impossible de récupérer la page cible. ["code" => "dJ5Dhe","host" => "ce-site-n-existe-pas.invalid","error" => "Could not resolve host: ce-site-n-existe-pas.invalid for \"https://ce-site-n-existe-pas.invalid/\"."]C’est le tableau passé en second argument du logger, le contexte, qui rend cette ligne utile. Le code du lien et le domaine fautif y sont, sans avoir été glissés dans le message, et un --search sur le domaine retrouve toutes les tentatives.
Notez que le Titre récupéré. de niveau info n’apparaît pas en production. La configuration de Monolog posée par la recette garde les logs en mémoire et ne les écrit que lorsqu’une erreur survient, avec tout ce qui l’a précédée. Dans les workers, son handler console écrit en plus les avertissements au fil de l’eau, c’est lui qui affiche la ligne ci-dessus.
Ces logs sont conservés 7 jours. Pour les garder plus longtemps, il faut les envoyer ailleurs avec un drain.
Les métriques fournies par la plateforme
Côté métriques, Clever Cloud collecte d’office les métriques système de chaque instance : CPU, mémoire, disque et réseau. La carte « Server metrics » de la vue d’ensemble de l’application en résume les 24 dernières heures, et l’onglet Metrics les détaille instance par instance. Une icône sur cette carte ouvre aussi des tableaux de bord Grafana préconfigurés.
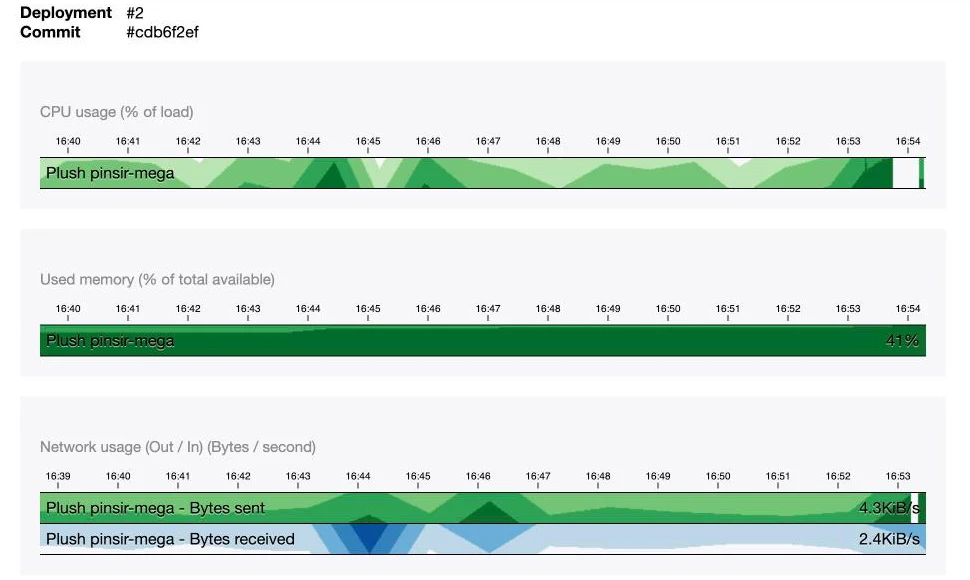
C’est un agent Telegraf, présent sur chaque instance, qui collecte l’essentiel de ces métriques et les range dans Warp 10, une base de données timeseries. L’onglet Metrics donne un jeton de lecture valable 5 jours, et un lien vers Quantum, l’éditeur en ligne de Warp 10, avec une première requête déjà écrite. Son langage, WarpScript, place les arguments avant l’opération (1 2 + au lieu de 1 + 2), ce qui déroute un peu au premier abord 🤯. Rassurez-vous, une ligne suffira pour la suite.
Des métriques métier avec Prometheus
Le CPU d’une instance ne dit évidemment pas combien de liens ont été créés aujourd’hui. Pour ça, l’application doit publier ses propres métriques, et Clever Cloud sait les collecter au format Prometheus : son agent interroge chaque minute une URL de l’instance, et range ce qu’il trouve dans Warp 10.
Le bundle installé plus haut compte déjà les requêtes HTTP par route, par famille de code de réponse, et leur durée. Ajoutons-y trois compteurs métier, dans un petit service :
final readonly class LinkMetrics
{
    public function __construct(
        private CollectorRegistry $registry,
    ) {
    }

    public function linkCreated(): void
    {
        $this->registry->getOrRegisterCounter('app', 'links_created_total', 'Liens créés')->inc();
    }

    public function linkVisited(): void
    {
        $this->registry->getOrRegisterCounter('app', 'link_redirects_total', 'Redirections servies')->inc();
    }

    public function titleFetchFailed(): void
    {
        $this->registry->getOrRegisterCounter('app', 'link_title_failures_total', 'Échecs de récupération du titre')->inc();
    }
}
Le contrôleur appelle linkCreated() après le dispatch() et linkVisited() à chaque redirection, le handler appelle titleFetchFailed() dans son catch. Le bundle ne rend pas son registre injectable par son type, une ligne dans config/services.yaml s’en charge :
services:
    Prometheus\CollectorRegistry: '@prometheus_metrics_bundle.collector_registry'
Ces compteurs ont besoin d’un stockage partagé, car PHP oublie tout à la fin de chaque requête, et le worker ne tourne pas dans le même processus que le serveur web. L’application a déjà un add-on Redis pour ses sessions, et le bundle accepte son URL :
artprima_prometheus_metrics:
    namespace: app
    storage: '%env(REDIS_URL)%'
En local, un conteneur Redis rejoint le compose.yaml, et la CLI Symfony en expose l’URL dans REDIS_URL.
La route /metrics/prometheus n’a rien à faire en accès libre. Protégeons-la avec un pare-feu dédié, en HTTP Basic, et un utilisateur en mémoire (pour le test, ça fera l’affaire) :
security:
    password_hashers:
        Symfony\Component\Security\Core\User\InMemoryUser: 'plaintext'
        # ...
    providers:
        metrics_scraper:
            memory:
                users:
                    prometheus: { password: '%env(CC_METRICS_PROMETHEUS_PASSWORD)%', roles: [ROLE_METRICS] }
    firewalls:
        metrics:
            pattern: ^/metrics/
            stateless: true
            provider: metrics_scraper
            http_basic: ~
        # ...
    access_control:
        - { path: ^/metrics/, roles: ROLE_METRICS }
Le mot de passe vient de CC_METRICS_PROMETHEUS_PASSWORD, la variable de la plateforme avec laquelle son agent s’authentifie : une seule valeur sert des deux côtés. Il reste à dire à l’agent où chercher, avec quatre variables Clever :
clever env set -a symfony-clever-demo CC_METRICS_PROMETHEUS_PORT 8080
clever env set -a symfony-clever-demo CC_METRICS_PROMETHEUS_PATH /metrics/prometheus
clever env set -a symfony-clever-demo CC_METRICS_PROMETHEUS_USER prometheus
clever env set -a symfony-clever-demo CC_METRICS_PROMETHEUS_PASSWORD "$(openssl rand -hex 16)"
Par défaut, l’agent attend les métriques sur le port 9100, alors que l’application répond sur le port 8080 de l’instance. Une minute après le déploiement, les compteurs arrivent dans Warp 10, préfixés par prometheus.. Dans Quantum, remplacez la requête pré-remplie par celle-ci, en gardant le jeton :
[ '<JETON>' '~prometheus.app_link.*' { 'app_id' 'app_xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx' } NOW 1 h ] FETCH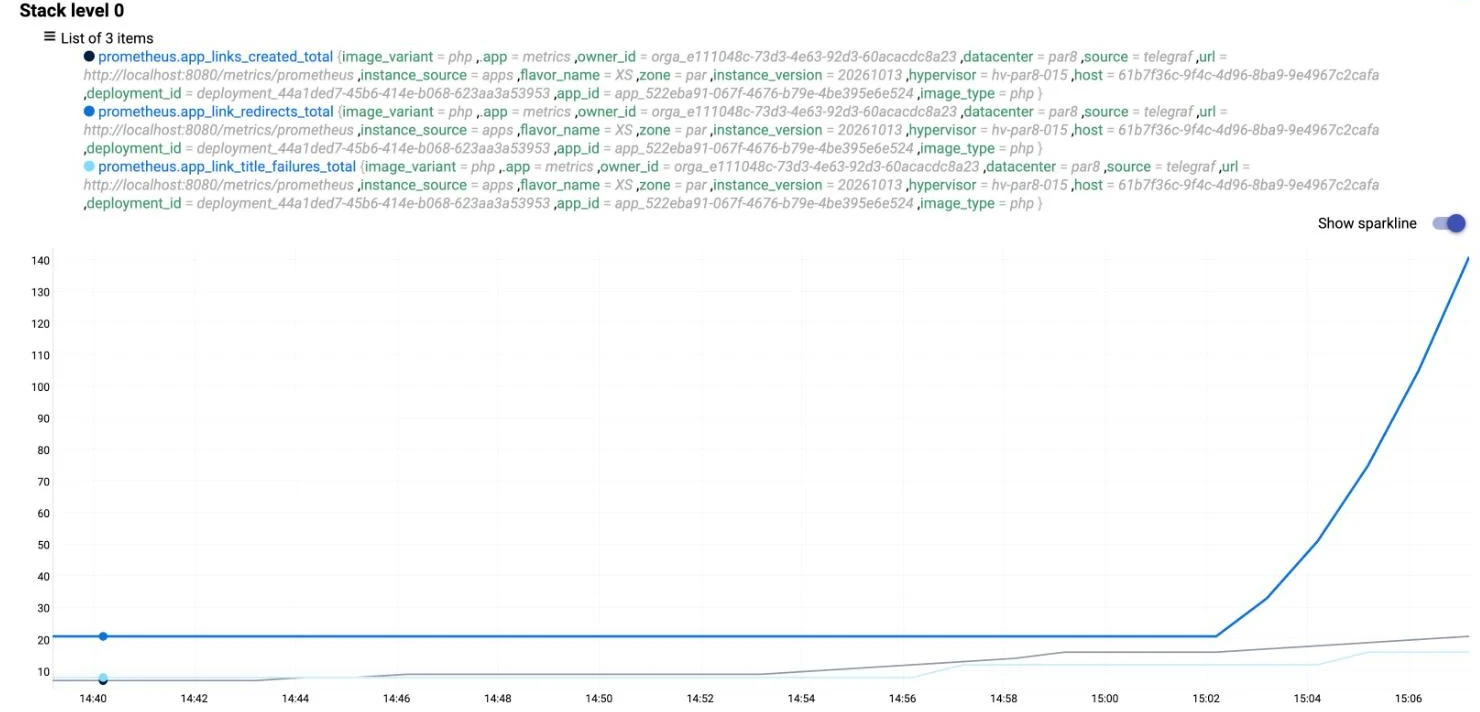
Gardez deux choses en tête. Les compteurs vivent dans Redis, donc chaque instance renvoie les mêmes valeurs : avec deux scalers, Warp 10 reçoit deux séries identiques, et les additionner compterait tout en double. Et ces métriques ne sont conservées que 7 jours, contrairement aux métriques système.
Suivre une requête avec OpenTelemetry
Avec les compteurs et les logs, on sait que la récupération du titre échoue, et sur quel site. Pour savoir où passe le temps d’un traitement lent, il faut le découper en étapes, et c’est le rôle des traces.
Clever Cloud ne stocke pas de traces, il faut un outil pour les recevoir. Pour l’exemple, j’ai choisi OpenObserve, open source, qui reçoit les traces au format OpenTelemetry et sert son interface sur le même port HTTP. Il s’héberge sur Clever Cloud dans une application Docker, construite à partir d’un Dockerfile d’une ligne, rangé dans clevercloud/openobserve.Dockerfile :
FROM openobserve/openobserve:v1.0.4O2_TOKEN="$(openssl rand -hex 16)"
clever create --type docker symfony-clever-o2 -a symfony-clever-o2
clever scale -a symfony-clever-o2 --flavor XS
clever env set -a symfony-clever-o2 CC_DOCKERFILE clevercloud/openobserve.Dockerfile
clever env set -a symfony-clever-o2 ZO_HTTP_PORT 8080
clever env set -a symfony-clever-o2 ZO_ROOT_USER_EMAIL vous@example.com
clever env set -a symfony-clever-o2 ZO_ROOT_USER_PASSWORD 'Un-Vrai-Mot-de-passe-42!'
clever env set -a symfony-clever-o2 ZO_ROOT_USER_TOKEN "$O2_TOKEN"
clever deploy -a symfony-clever-o2CC_DOCKERFILE désigne ce Dockerfile, et ZO_HTTP_PORT aligne OpenObserve sur le port 8080 qu’attend Clever Cloud. OpenObserve refuse de démarrer si le mot de passe ne mélange pas minuscules, majuscules, chiffres et caractères spéciaux. Le déploiement prend une trentaine de secondes.
⚠ Une application Docker n’a pas accès aux FS Buckets : les données d’OpenObserve disparaissent à chaque redéploiement, jeton d’ingestion compris. C’est pour ça qu’on le fixe avec ZO_ROOT_USER_TOKEN. Pour l’exemple, perdre l’historique n’est pas bien grave. Pour un usage réel, OpenObserve sait ranger ses données dans un bucket S3, comme Cellar.
Passons à l’application, avec les variables standard d’OpenTelemetry :
# Dans le même shell : O2_TOKEN est celui généré plus haut
clever env set -a symfony-clever-demo OTEL_PHP_AUTOLOAD_ENABLED true
clever env set -a symfony-clever-demo OTEL_SERVICE_NAME symfony-clever-demo
clever env set -a symfony-clever-demo OTEL_EXPORTER_OTLP_PROTOCOL http/json
clever env set -a symfony-clever-demo OTEL_EXPORTER_OTLP_ENDPOINT https://<domaine-openobserve>/api/default
clever env set -a symfony-clever-demo OTEL_EXPORTER_OTLP_HEADERS \
  "Authorization=Basic $(printf 'vous@example.com:%s' "$O2_TOKEN" | openssl base64 -A)"
OTEL_PHP_AUTOLOAD_ENABLED démarre le SDK, OTEL_SERVICE_NAME nomme l’application dans OpenObserve, et http/json évite d’avoir à installer Protobuf. L’en-tête encode l’adresse e-mail et le jeton posés sur OpenObserve.
Reste un détail propre aux workers. Le SDK n’envoie pas chaque span dès qu’il se termine, il les accumule, et les envoie quand le processus s’arrête ou quand un span suivant se termine. Une requête web s’arrête vite, mais un worker tourne une heure : lors de mes tests, la trace d’un message isolé n’était toujours pas arrivée au bout de plusieurs minutes. Un listener sur les événements du worker force l’envoi après chaque message :
#[AsEventListener(event: WorkerMessageHandledEvent::class)]
#[AsEventListener(event: WorkerMessageFailedEvent::class)]
final class FlushTracesListener
{
    public function __invoke(): void
    {
        $tracerProvider = Globals::tracerProvider();

        if ($tracerProvider instanceof TracerProviderInterface) {
            $tracerProvider->forceFlush();
        }
    }
}
TracerProviderInterface est celle du SDK, OpenTelemetry\SDK\Trace\TracerProviderInterface. Quand le SDK n’est pas démarré, Globals renvoie une implémentation vide, et le listener ne fait rien.
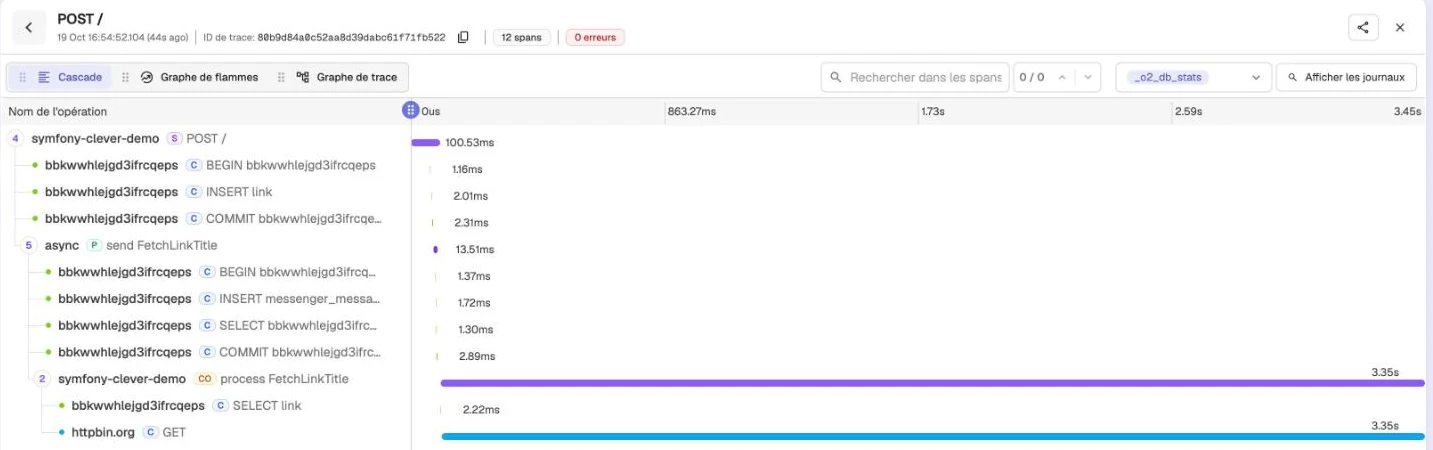
Déployons, créons quelques liens, et ouvrons la page Traces d’OpenObserve. Chaque requête web y a sa trace, avec la route, le code de réponse, la durée et ses requêtes SQL. La création d’un lien va plus loin : le bundle fait voyager le contexte de la trace avec le message, et son traitement par le worker vient s’ajouter à la même trace. On y lit l’INSERT du lien, l’envoi du message, puis, côté worker, l’appel au site cible et, si la page a un titre, l’UPDATE qui l’enregistre. Pour une page qui met 3 secondes à répondre (httpbin.org/delay/3), cet appel pèse 3,349 s sur les 3,352 s du traitement.
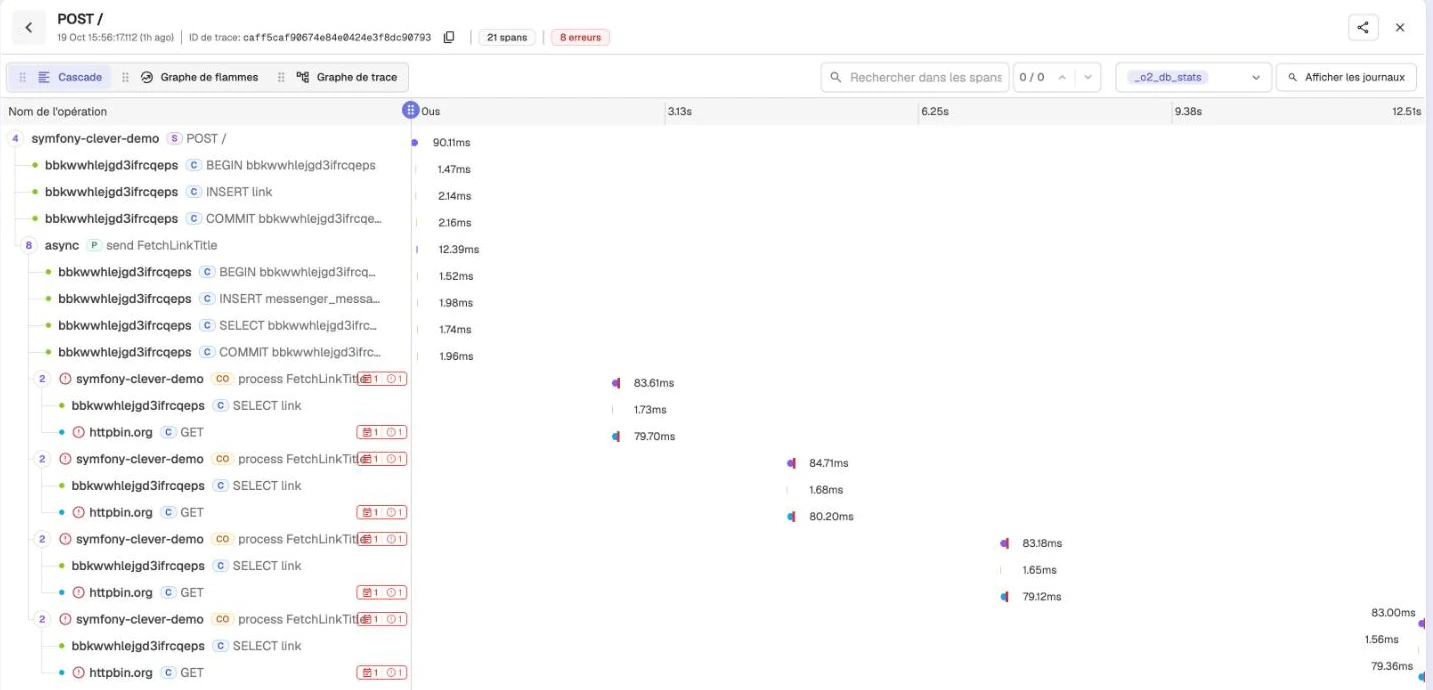
Les échecs ressortent en rouge, avec le message de l’exception, et les nouvelles tentatives s’ajoutent elles aussi à la trace.
Les logs en profitent. Le bundle ajoute à chaque ligne l’identifiant de la trace en cours, et l’avertissement vu plus haut devient :
WARNING [app] Impossible de récupérer la page cible. ["code" => "GfRCHE","host" => "toujours-absent.invalid","error" => "…"] ["trace_id" => "3a0122646a1e41c0c27c0da4bca45197","span_id" => "4b709fdcef432225","trace_flags" => "01"]Il suffit de chercher ce trace_id dans OpenObserve pour retrouver la création du lien, l’envoi du message et chaque tentative. Dans l’onglet Logs de la console, les quatre tentatives d’un même message portent d’ailleurs le même trace_id.
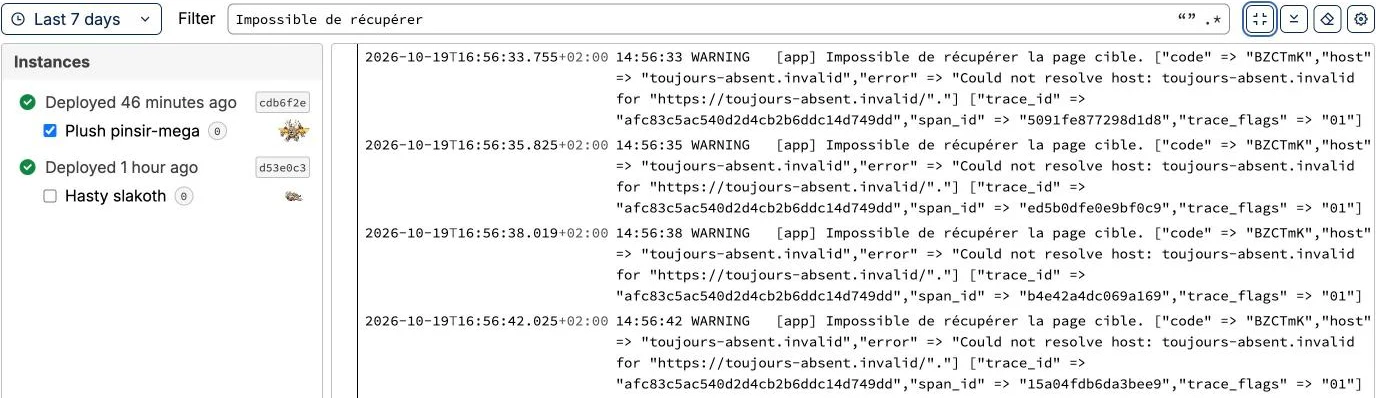
Enfin, vous verrez passer chaque minute, sur chaque instance, la requête de l’agent Telegraf sur /. Celle qu’il fait sur /metrics/prometheus n’apporte rien, la configuration du bundle l’écarte des traces, avec le healthcheck :
open_telemetry:
    traces:
        excluded_paths: ['/_profiler', '/_wdt', '/cc-health', '/metrics/']
Être prévenu quand ça casse
Pour les déploiements, Clever Cloud prévient déjà : ses notifications envoient par défaut un e-mail à chaque déploiement réussi ou échoué, et peuvent aussi appeler un webhook.
Pour l’application elle-même, OpenObserve sait déclencher des alertes sur ses propres données. Dans son menu Fiabilité, créez d’abord une destination : Slack, Discord, Microsoft Teams ou PagerDuty ont chacun un modèle prêt à l’emploi, et pour Slack, l’URL d’un webhook entrant suffit. Créez ensuite une alerte sur le flux de traces default, en mode SQL :
SELECT trace_id, operation_name FROM "default" WHERE span_status = 'ERROR'Vérifiée chaque minute sur les cinq dernières minutes, avec un seuil à 1, elle se déclenche dès qu’un span est en erreur. Lors de mes tests, la notification est arrivée moins d’une minute après l’échec. Comme le reste des données d’OpenObserve, destinations et alertes disparaissent à chaque redéploiement de son application : notez leur configuration quelque part.
Pour conclure
Le raccourcisseur publie maintenant ses compteurs dans Warp 10 et ses traces dans OpenObserve, et un lien vers un site injoignable déclenche une alerte en moins d’une minute.
Code source. La branche
07-observabilitydu dépôt de la série contient le raccourcisseur, ses compteurs et l’instrumentation OpenTelemetry. En local,docker compose up -ddémarre aussi Redis et un OpenObserve sur http://localhost:5080. Les commandes de création de l’application OpenObserve et les variables à poser sur l’application web sont dans leREADMEde la branche.